

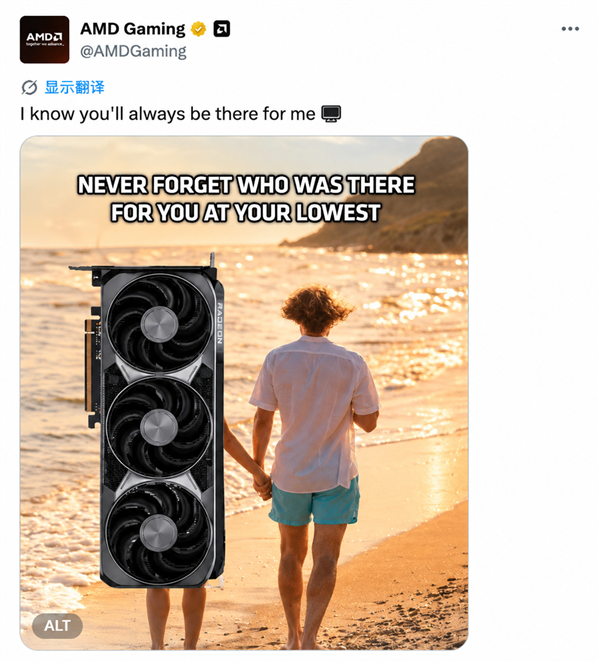
AMD游戏部门近日在外交媒体发布了一张颇为耐东说念主寻味的海报:一个东说念主在海滩上手牵一块Radeon显卡开云官网切尔西赞助商,配文我知说念你会一直伴随我,图片翰墨还提醒粉丝别忘了是谁在你最低谷时支握了你。
不外这条情感向的帖子并未收货预期中的共识。不少玩家在驳斥区抒发了相背的感受——AMD并莫得“陪在他们身边”。
多条恢复还援用了AMD CEO苏姿丰近期的公开表态:她在11月5日秉承Yahoo Finance采访时,谈及AI需求与数据中心增万古称“咱们是一学派据中心优先的公司”。
从时刻点看,这条海报的发布颇为隐痛:就在前一天,黄仁勋辞任NVIDIA CEO的音书公开,公司CFO Colette Kress出任临时CEO。
玩家的起火有具体事实因循:本世代Radeon显卡现时莫得一款能以提议零卖价买到;本年AMD除面向OEM商场的RX 9050系列外,莫得发布任何新显卡。
何况官方在很长一段时刻后才阐发将为上一代GPU提供FSR4支握。
营销层面的落差雷同清亮。自Radeon业务发扬东说念主Scott Herkelman辞职后,AMD的显卡营销险些失去存在感,常常只体现时发布会的一页幻灯片或一小段试验中。
RDNA 4的公布样子就很典型:它仅出现时演示文稿里,CES现场演讲中莫得花一秒时刻张开先容。
更逶迤的是,苏姿丰仍是很久莫得在公开舞台上磋商Radeon显卡,她近期的言论与其说是采访中的口误,不如说印证了玩家已有的感受:被生僻。
AMD本不错作念得更好,也如实应该作念得更好。
不外,Radeon在零卖端受生僻,并不等于AMD图形本领退场。
索尼、微软下一代主机也会不竭用AMD的定制芯片,其中微软的Xbox Helix性能会比PS6还强,这一次定制的Magnus芯片性能会很浩繁。
比这更好的音书是AMD这次的商场计谋也有可能不一样了,定制的主机芯片有可能会外卖给其他厂商,日前曝光的一个产物系列即是Siren Halo,它即是Magnus同级别芯片,配备AT2级别GPU单位,68组CU单位。
但在CPU上有所不同,Xbox用的Magnus是3个Zen6中枢及8个Zen 6c 中枢,所有11个,而Siren Halo降至4个Zen6、4 个Zen6c和2个低功耗中枢。
内存系统也不太一样,Magnus主机芯片是192bit GDDR7内存,Siren Halo还会极端支握LPDDR内存,还不太笃定是LPDDR5X如故最新的LPDDR6。
此外,Siren Halo还会有更低功耗的GPU单位,8组CU,RDNA4m架构,在超大核显用不到的时候启用,以裁汰功耗。
从CPU、LPDDR内存再到低功耗核显的加入,Siren Halo的这个策画清亮是跟主机芯片同款但不同用途,因为AMD会把这个芯片怒放给其他客户,简单PC厂商相当他客户打造我方的游戏机产物。
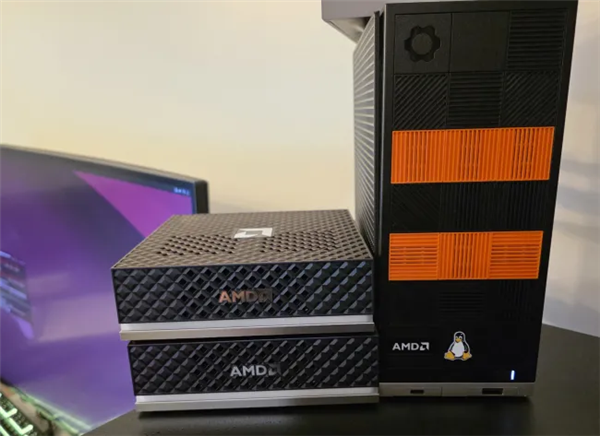
一个可能的合营伙伴是Valve,后续的Steam Machine游戏主机有可能基于这个芯片打造。
另外的合营伙伴是各大PC厂商,打造我方的Windows游戏主机,这个地方亦然这两年来的热门,信托会有厂商快活作念的。
至于把定制版芯片拿出来外卖给其他厂商,会不会让微软不欢喜,或者影响Xbox主机销量,这个应该是多虑了,Siren Halo的合座定位应该会比Magnus阉割一些,可能是用后者的不良品屏蔽而来,性能不会挟制到Xbox主机。
其次,Xbox主机的固件、系统跟PC或者Valve的SteamOS也不会换取,游戏是不会让你通用的,各家平台如故得找各家的刊行商,因此主机的中枢利益不会受损。
至于为什么会出这么的产物,比拟AMD、微软、索尼他们也齐解析这两年内存大涨,主机的销量笃信也会受影响,而Magnus这么的定制芯片资本不低,不拿出来多卖一些是不好收场资本的。
主机芯片靠范围摊薄资本,AMD也在软件侧降本增效。
AMD工程师近期完成了一项极具冲破性的本领实验,诈欺全新的HRX Loom软件与智能体AI使命流,在短短三天内将50个热门大模子成效移动至AMD消费级显卡硬件。
这不仅展示了AMD在端侧AI范围的快速适配能力,也预示着大模子在个东说念主PC上的普及成果将大幅普及。
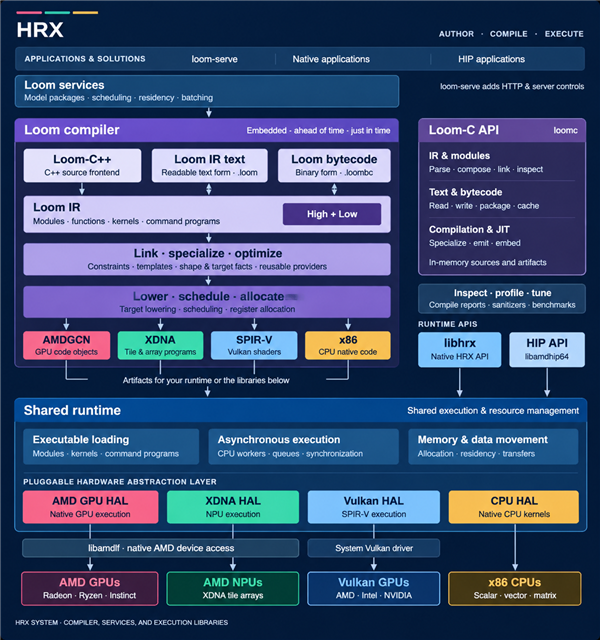
据了解,这次实验由AMD工程师Jeremy Fowers和Ben Vanik主导。他们通过引入智能体AI使命流,让AI偶然自主编写和优化适配AMD显卡的模子行为,从而在三到四天内完成了波及18种不同架构的50款Hugging Face热门模子的移动。
要知说念,盛名AI模子托管平台Hugging Face是现时民众最大的开源AI社区,以往将这些模子逐个适配到特定硬件需要糟践数月时刻。
在性能测试中,实验团队诈欺代号为Strix Halo的锐龙AI Max硬件进行了深度考证。
闭幕透露,在处置32K Token的长辅导词时,HRX Loom软件的驱动速率比现时主流的Llama.cpp ROCm后端普及了1.5至2.1倍,比拟Vulkan后端也有1.9倍的性能上风。
需要阐发的是,HRX Loom现时仍是AMD的实验性状貌,但上述闭幕仍是透露出可不雅的后劲。它也不单面向GPU,雷同支握CPU和NPU推行。
实验闭幕已通过GitHub的Loom-Fun页面公开。当作使命的一部分,AMD还提供了名为loom-skills的请托物,可为Claude Code、Codex或Pi等编程智能体配备必要组件,使其偶然编写并向AMD客户端GPU部署优化后的模子行为。
现时的测试重心麇集在Strix Halo硬件上,举例Ryzen AI Halo和Framework Desktop这类设置。
 开云官网切尔西赞助商